Nếu chỉ nhìn qua demo ngắn, nhiều AI agent trông khá thông minh. Nó trả lời nhanh, gọi tool ổn, thậm chí biết suy luận từng bước. Nhưng đem ra dùng vài ngày là lộ ngay một vấn đề rất người mà lại rất máy: mất trí nhớ.
Agent không nhớ mình là ai trong workflow của anh, không nhớ trước đó đã thử cách nào, không nhớ preference nào quan trọng, và cũng không nhớ vì sao một hướng xử lý từng fail. Nếu hệ cứ reset về gần như số 0 ở mỗi phiên, thì nó chỉ là chatbot biết gọi tool, chưa phải agent đáng tin để giao việc lâu dài.
Table of contents
Open Table of contents
Kết luận nhanh
- Context window chỉ là bàn làm việc tạm thời, không phải bộ nhớ dài hạn.
- Agentic memory nên tách thành ba mục tiêu: continuity, context, và learning.
- Một hệ thực dụng thường cần bốn lớp nhớ: context window, external memory, episodic memory, và parametric memory.
- Điểm khó thật không nằm ở chỗ lưu vào đâu, mà nằm ở chỗ kéo đúng thứ quay lại đúng thời điểm.
- Hệ nhớ tốt phải có cả cơ chế ghi nhớ lẫn cơ chế quên bớt.
Vì sao agent cần memory thật sự
LLM rất mạnh trong một forward pass, nhưng bản chất của nó vẫn là stateless giữa các phiên. Nó không tự biết hôm qua anh đã giao gì, preference nào là cứng, hay chiến lược nào từng dùng xong cho kết quả tệ. Mọi thứ chỉ tồn tại nếu mình chủ động đưa lại vào context.
Với chatbot đơn giản, chuyện này chưa chắc là vấn đề. Nhưng với agent chạy workflow nhiều bước, có tool call, có quyết định nối tiếp, có trạng thái công việc và lịch sử phối hợp với user, thì đây là giới hạn kiến trúc chứ không còn là bất tiện nhỏ nữa.
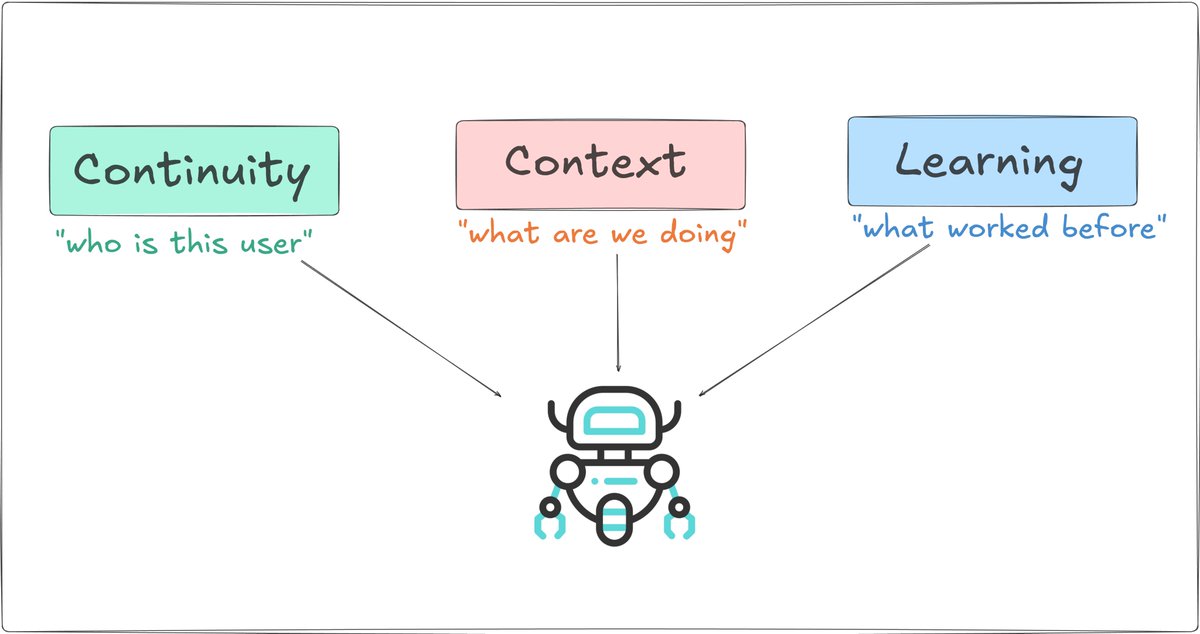
Minh hoạ gốc từ thread của @techwith_ram, dùng lại để giải thích continuity, context, và learning.
Muốn agent dùng được lâu dài, memory phải phục vụ ít nhất ba việc khác nhau.
Continuity
Continuity là lớp giúp agent giữ được cảm giác nhất quán qua thời gian. Nó gồm những thứ như user preference, mục tiêu dài hạn, project đang theo đuổi, convention khi viết, hay các decision trước đó không nên hỏi lại từ đầu.
Không có continuity thì mỗi lần mở chat mới là một lần khởi động lại quan hệ làm việc.
Context
Context là những gì agent cần để không làm rơi task đang chạy: message gần nhất, tool output vừa trả về, bước nào đã xong, bước nào còn pending, và dữ liệu nào phải giữ trong vòng xử lý hiện tại.
Không có context sạch, workflow nhiều bước sẽ gãy ở những chỗ rất ngớ ngẩn.
Learning
Learning là phần nhiều hệ bỏ qua nhất. Agent không chỉ cần nhớ fact; nó còn cần nhớ outcome. Cách nào từng hiệu quả, cách nào từng fail, sai ở đâu, và pattern nào nên tránh lặp lại.
Nếu không có lớp này, agent có thể rất hiểu lý thuyết nhưng vẫn liên tục phạm lại cùng một lỗi thao tác.
Bốn lớp memory nên tách riêng
Nhìn thực dụng, một agent đủ khỏe thường không có một “bộ nhớ duy nhất”. Nó có nhiều lớp, mỗi lớp làm một việc khác nhau.
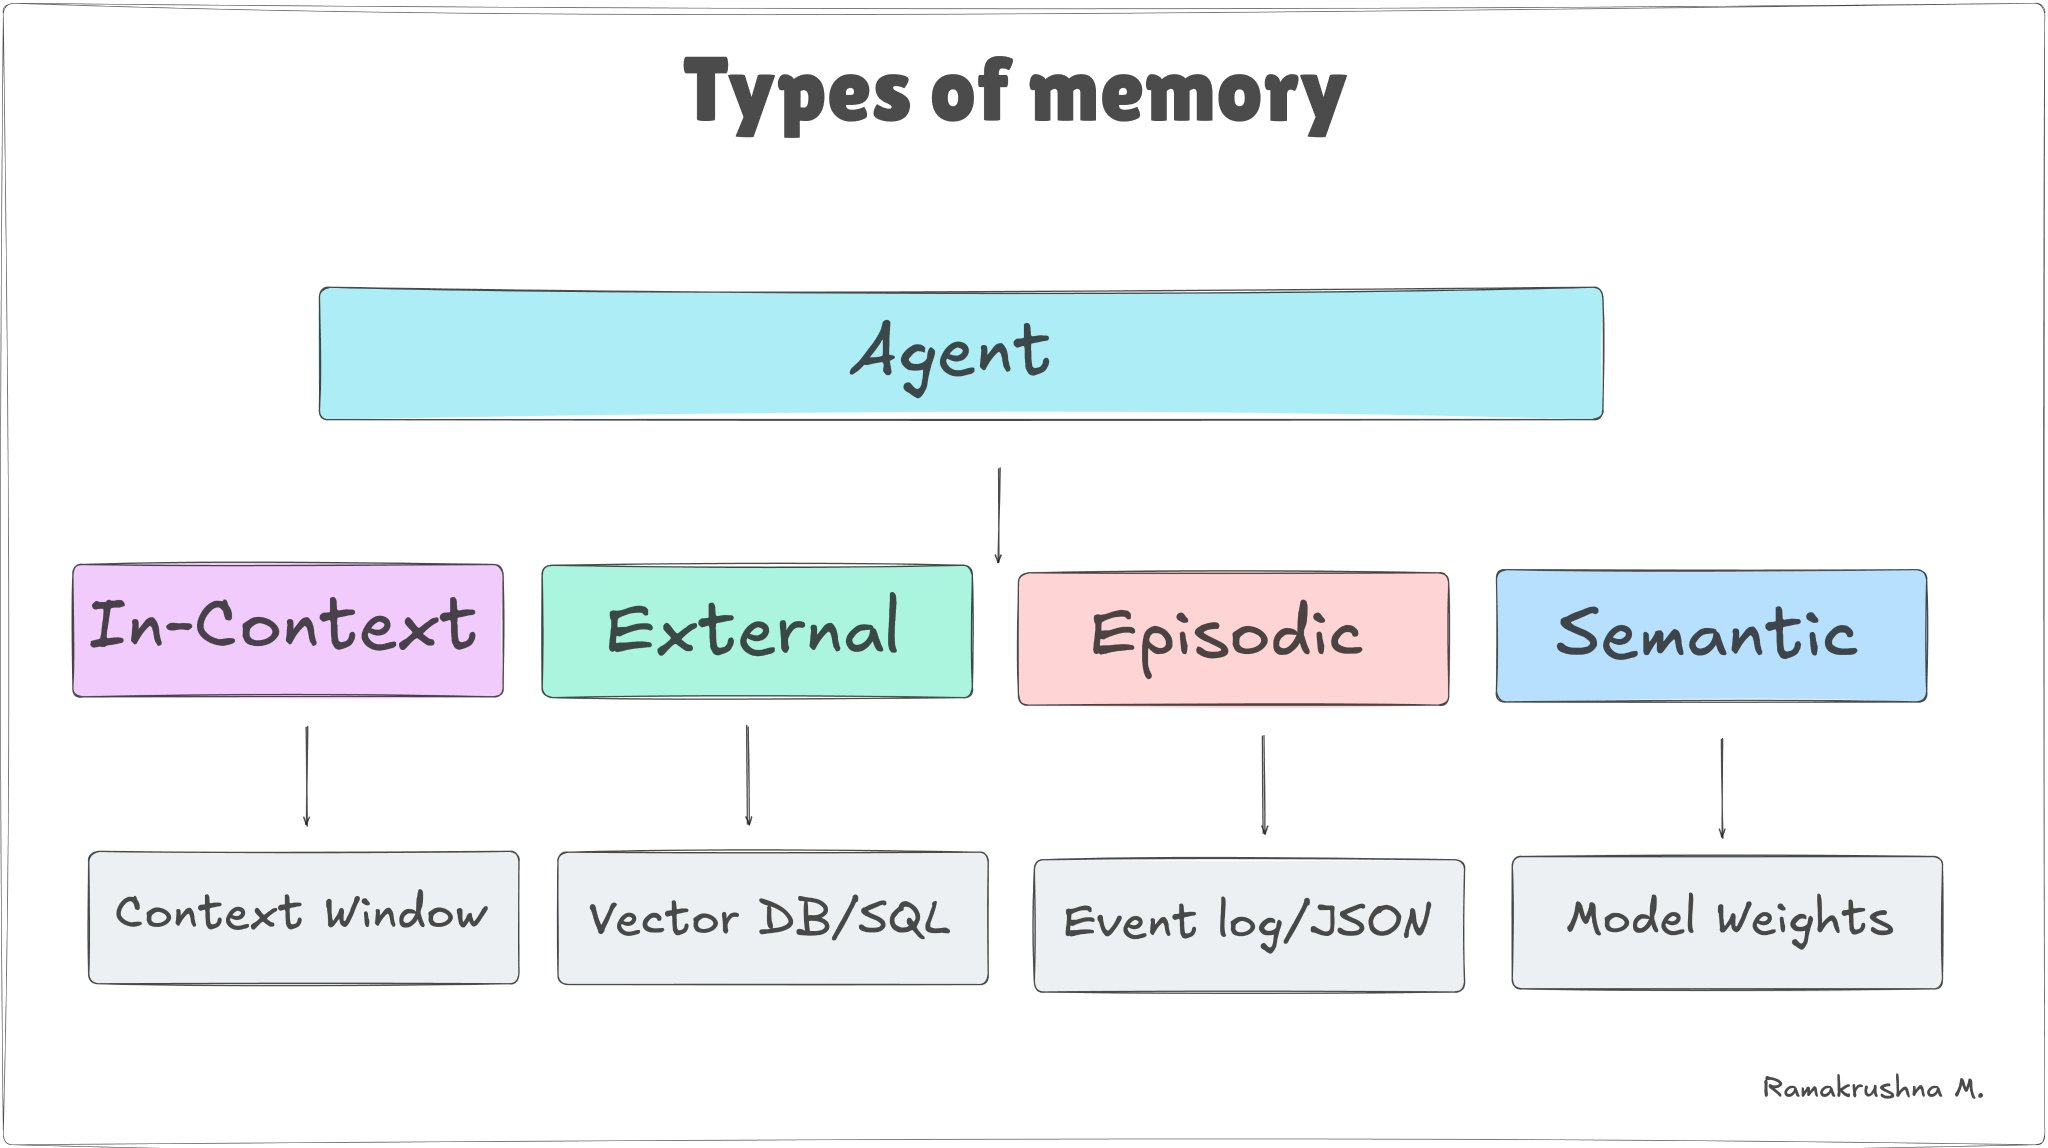
Một taxonomy dễ dùng trong thực tế: working memory, persistent memory, episodic memory, và parametric memory.
Context window
Đây là working memory. Những gì nằm trong context window đều được model truy cập trực tiếp ở lần suy luận hiện tại: system prompt, chat history, tool output gần đây, memory vừa retrieve vào, và đôi khi cả scratchpad.
Ưu điểm của nó là tức thời. Nhược điểm là đắt, hữu hạn, và bay mất khi phiên kết thúc.
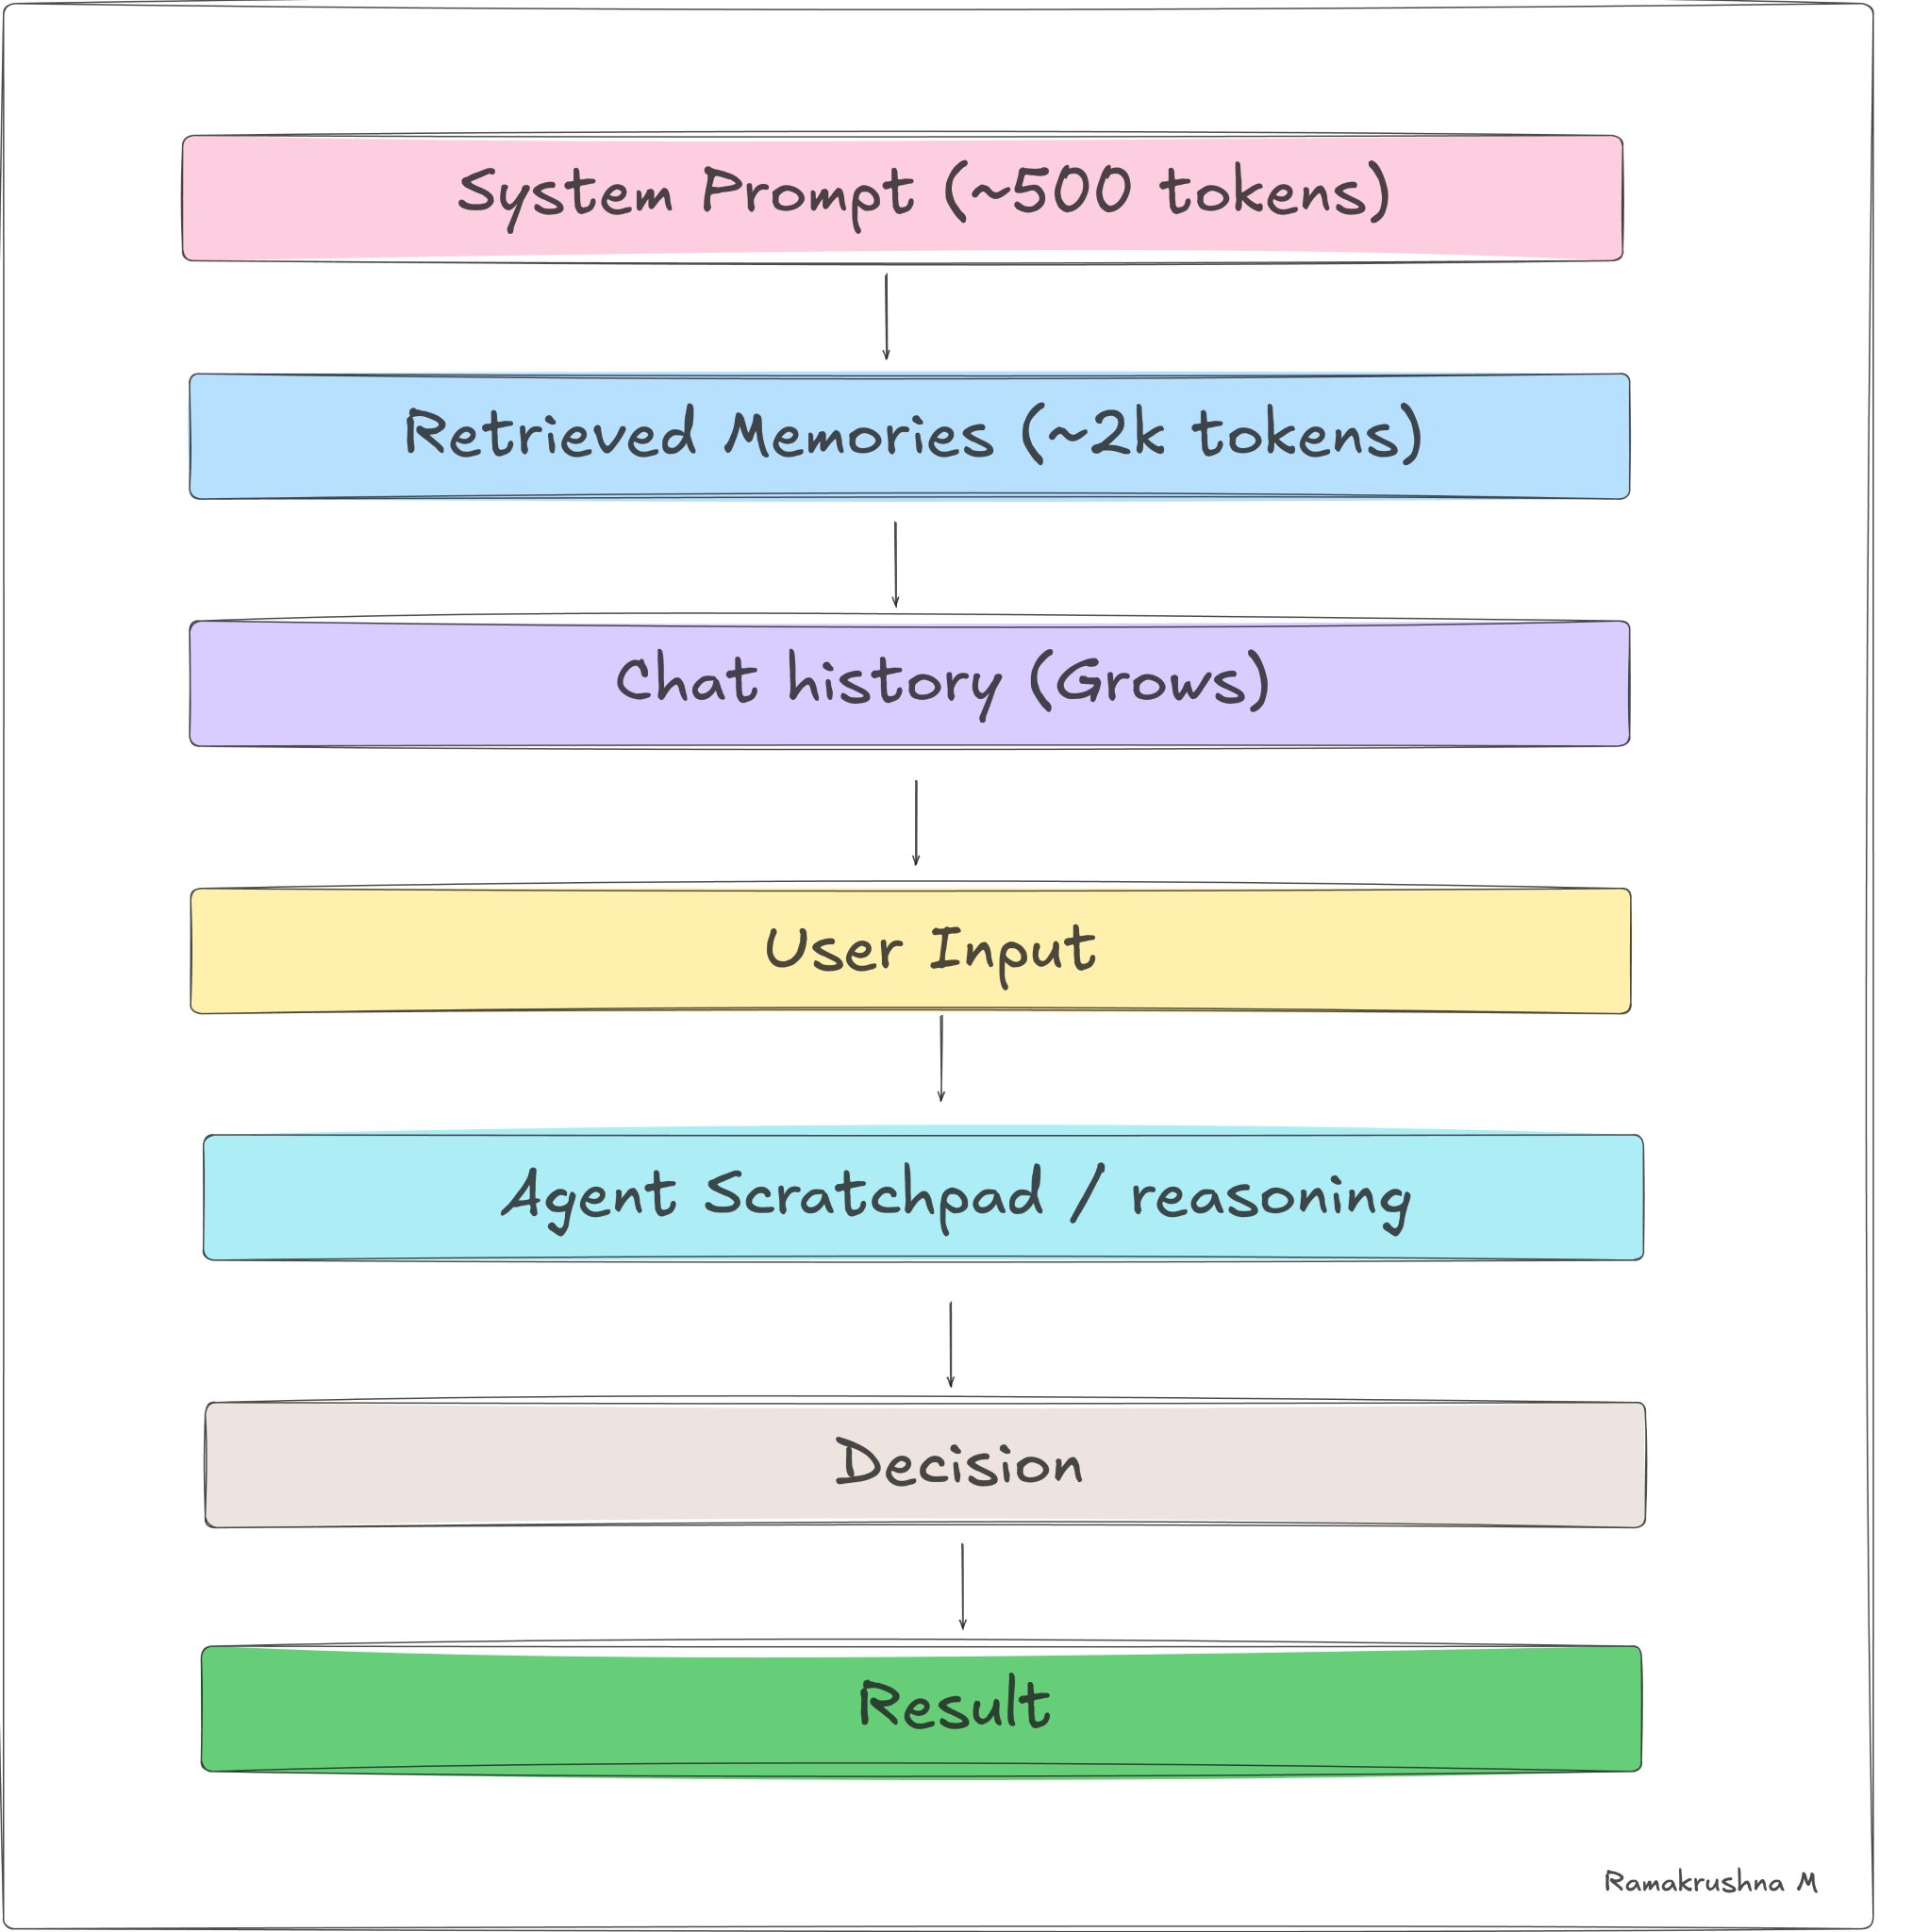
Context window hợp để suy luận ngắn hạn, không hợp để làm durable storage.
Sai lầm phổ biến là cố nhét mọi thứ vào context thật lâu. Cách đó chỉ làm token cost tăng, latency tăng, và tín hiệu quan trọng bị chìm trong nhiễu.
External memory
External memory là mọi thứ sống ngoài model và tồn tại qua nhiều phiên: database, vector store, key-value store, files, logs.
Thường nên chia tiếp thành hai loại:
- Structured store cho exact lookup như profile, settings, status, record có schema.
- Semantic store cho recall theo nghĩa như note, transcript, insight, đoạn giải thích, hoặc episode có embedding.
Đây là lớp bắt buộc nếu anh muốn agent nhớ được thứ gì đó từ hôm qua, tuần trước, hay từ một project khác mà không phải paste tay vào prompt.
Episodic memory
Episodic memory không lưu “sự thật tĩnh”, mà lưu “việc đã xảy ra”. Ví dụ:
- task là gì,
- đã chọn approach nào,
- outcome ra sao,
- tốn bao lâu,
- quality ổn hay không,
- có lesson nào rút ra được.
Thứ này cực kỳ quan trọng với agent làm việc thật, vì phần lớn lỗi không phải do agent thiếu kiến thức, mà do nó lặp lại workflow tệ.
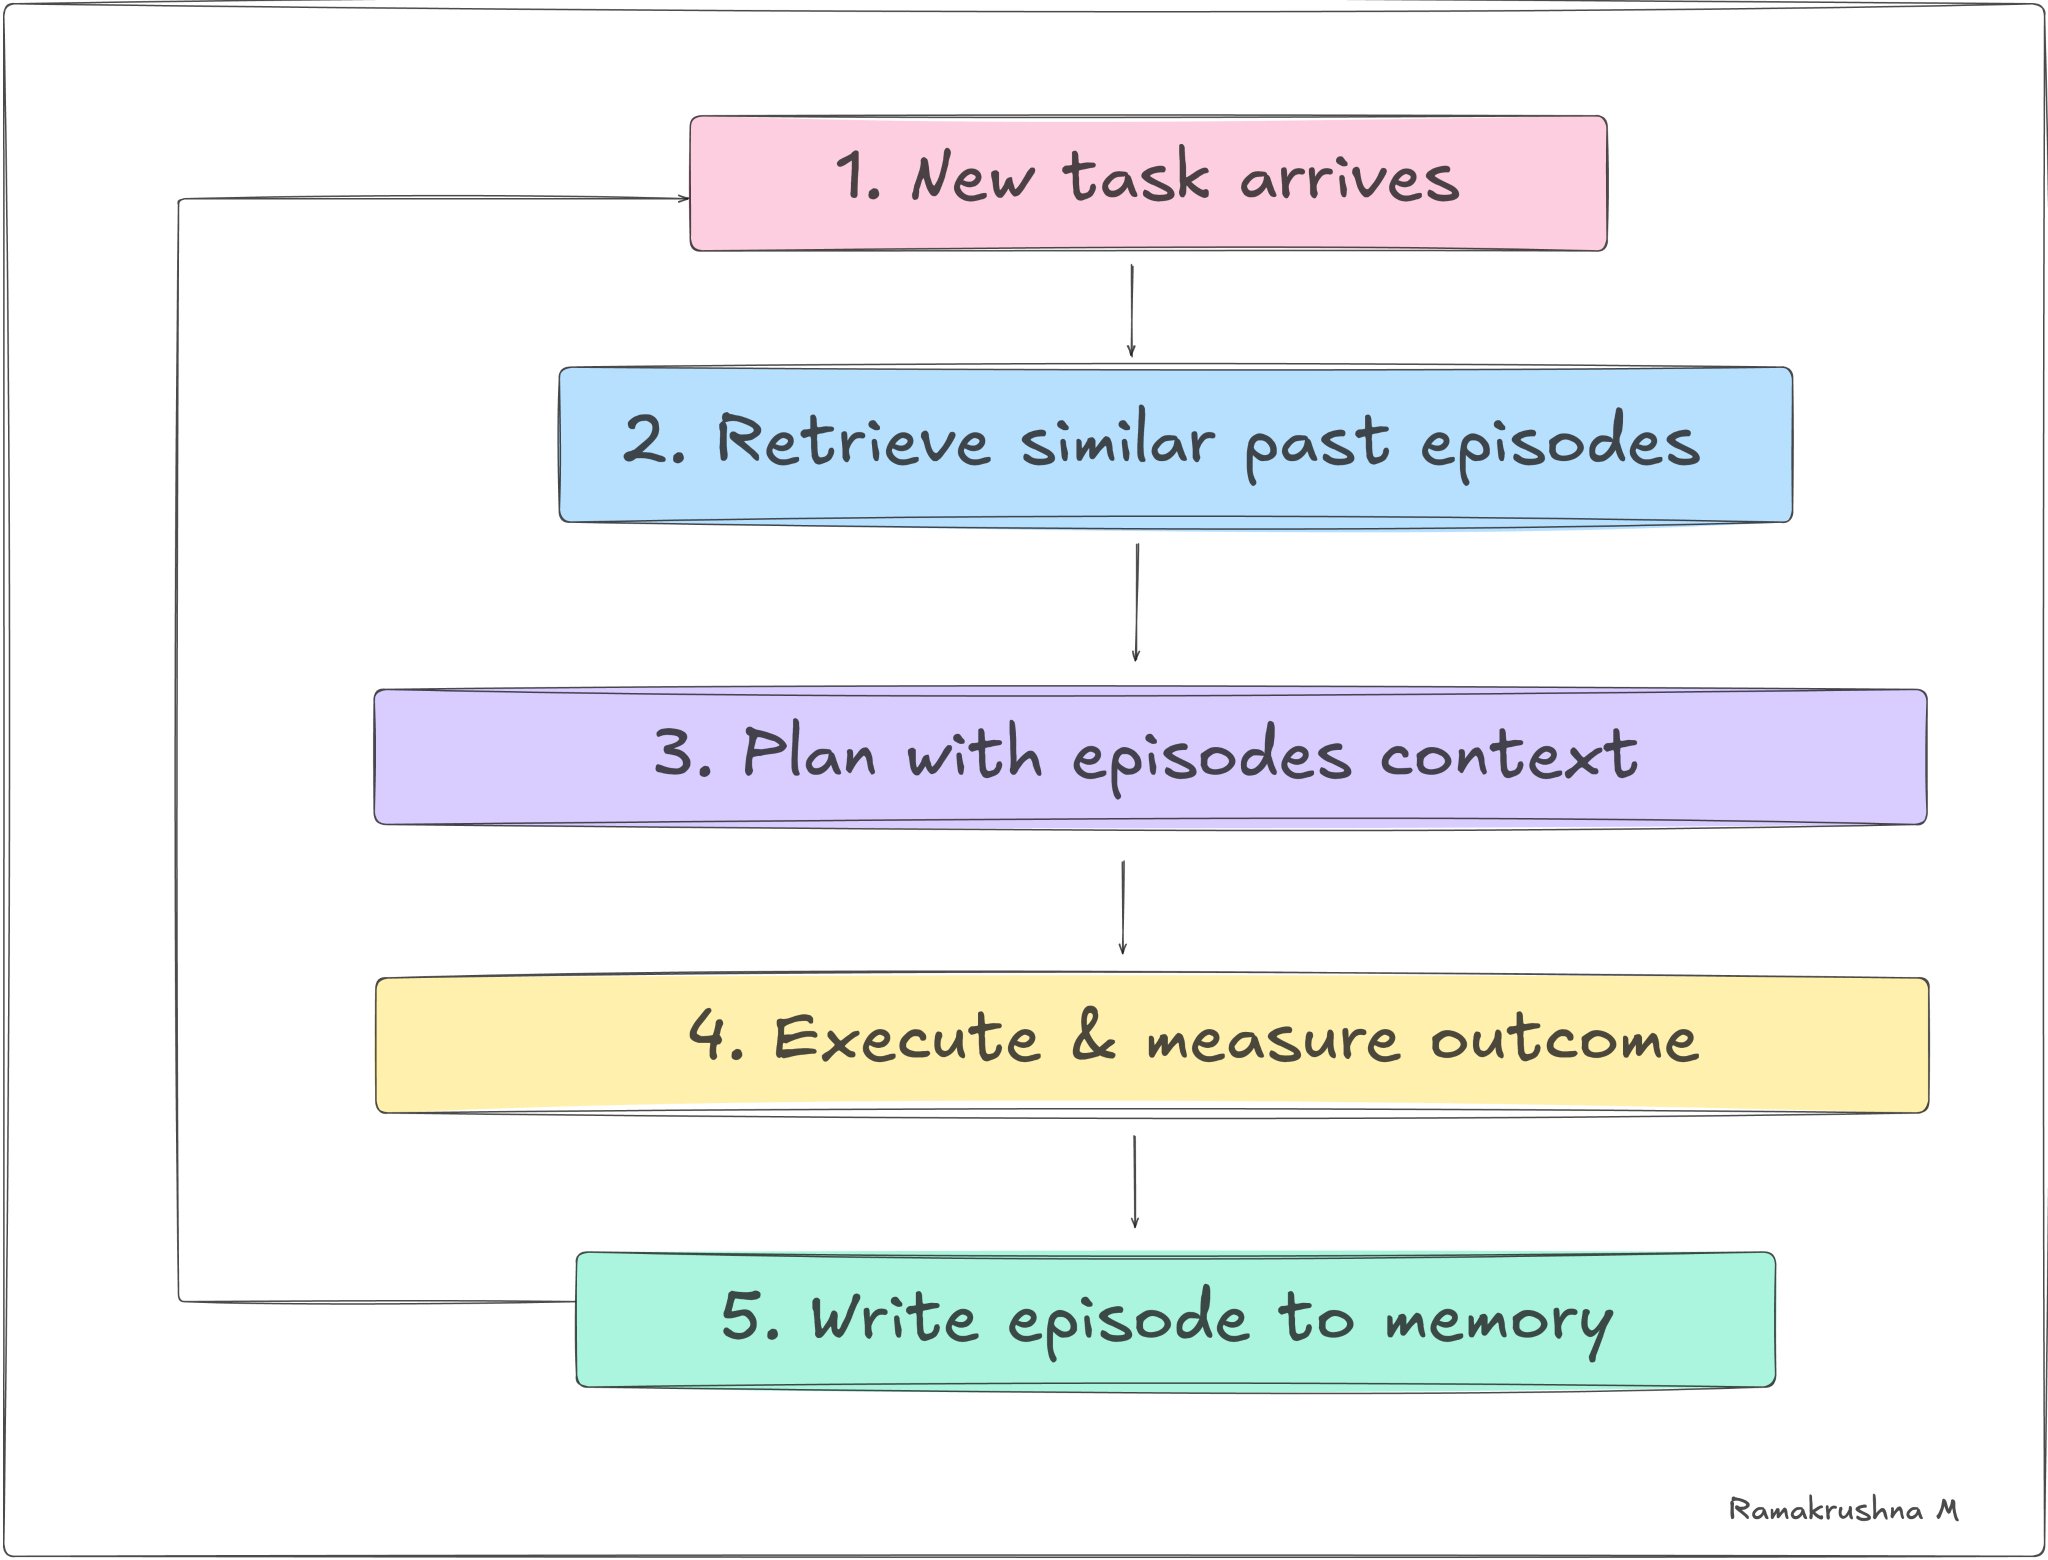
Nếu không có reflection loop, agent khó mà tiến bộ qua nhiều vòng làm việc.
Parametric memory
Đây là phần model đã học sẵn trong weights: ngôn ngữ, pattern, coding convention, tri thức phổ quát, và các heuristic suy luận chung.
Nó luôn sẵn có, nhưng có ba vấn đề:
- bị đóng băng theo thời điểm train,
- không update runtime theo cách kiểm soát được,
- và rất dễ hallucinate khi thiếu dữ kiện mới.
Vì vậy, parametric memory nên được xem là nền học vấn chung của agent, không phải nguồn sự thật cho thứ time-sensitive, private, hay user-specific.
Retrieval mới là cổ chai thật sự
Nhiều người nghĩ memory system chủ yếu là bài toán storage: dùng Postgres, Redis, Chroma, hay Qdrant. Thực ra, khác biệt sống còn nằm ở retrieval.
Một hệ có thể lưu hàng chục nghìn memory nhưng vẫn hành xử như không nhớ gì nếu:
- retrieve sai chunk,
- rank sai theo recency và relevance,
- đưa quá nhiều nhiễu vào prompt,
- hoặc không biết khi nào nên summarize thay vì nạp nguyên văn.
Nói gọn, memory architecture chỉ khoảng 20% là chỗ lưu, còn 80% là retrieval design, compression, scoring, filtering, và lifecycle policy.
Agent loop nên chạy như thế nào
Một loop tối thiểu nhưng đủ xài thường có dạng này:
- Nhận task mới.
- Retrieve fact liên quan và episode tương tự.
- Nạp có chọn lọc vào context window.
- Cho agent chạy task và quan sát outcome.
- Ghi lại durable fact hoặc episode nào đáng giữ cho lần sau.
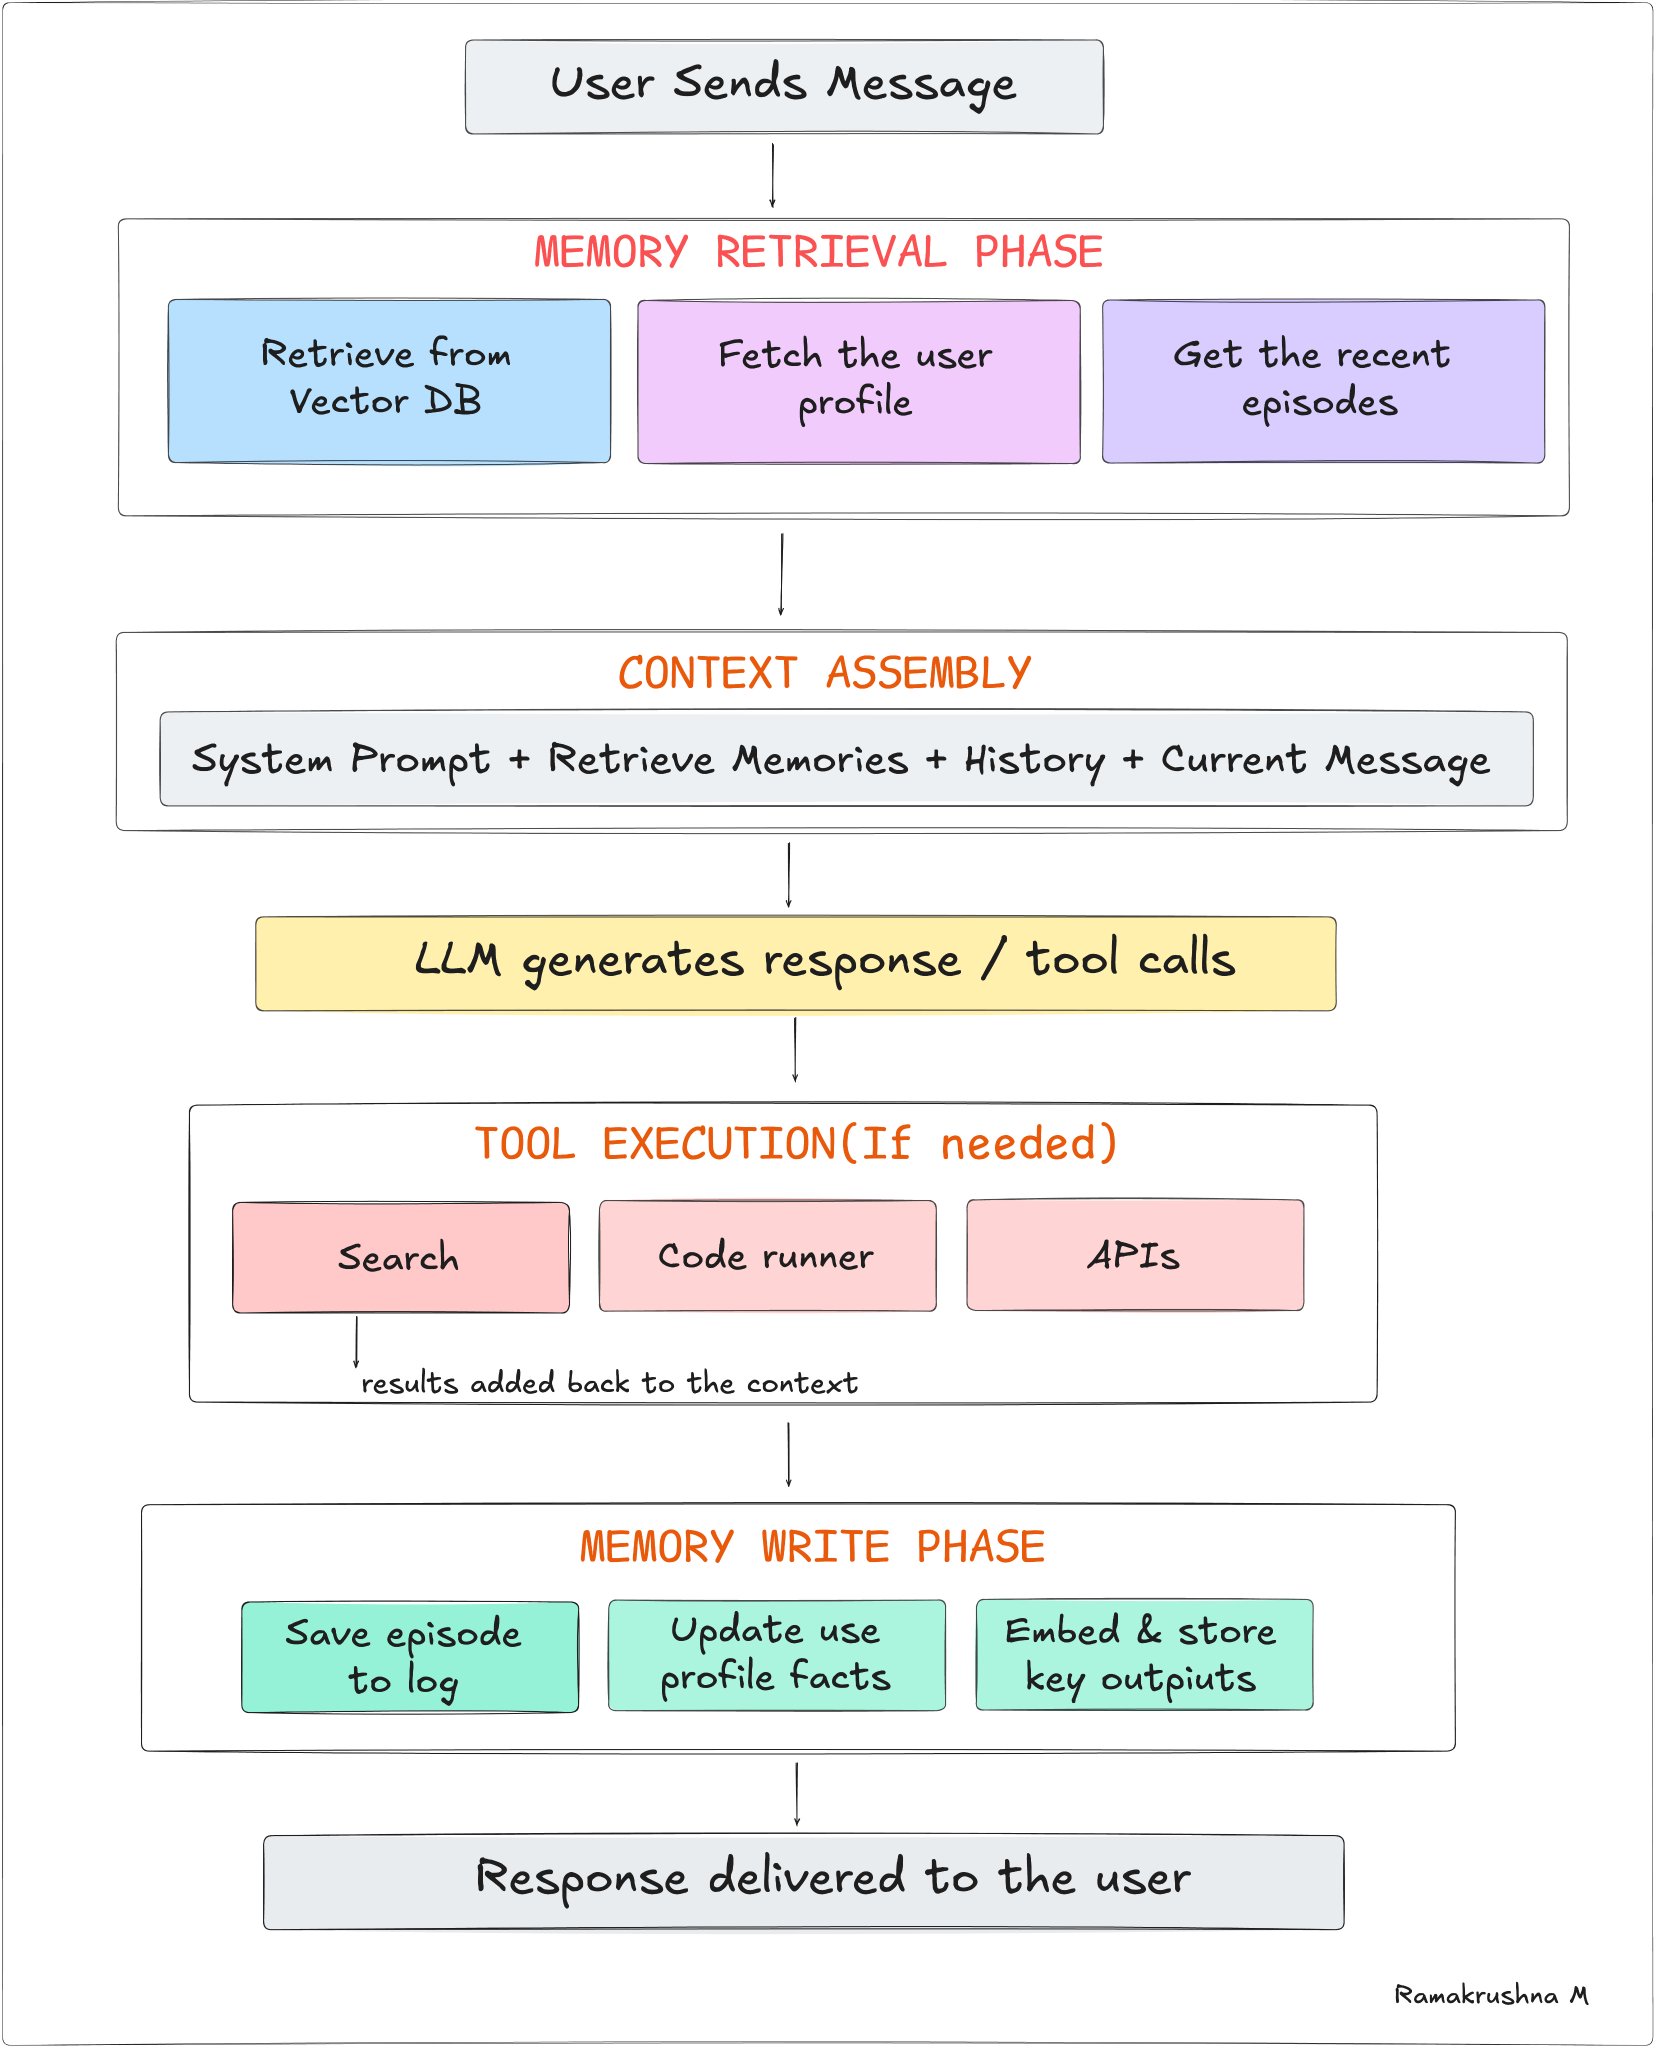
Retrieve trước, write-back sau. Chính vòng này tạo ra cảm giác agent có state dù model gốc là stateless.
Nếu làm kỹ hơn, anh có thể thêm:
- importance scoring để chặn rác từ đầu,
- recency decay để memory cũ tự hạ trọng số,
- summarization theo mốc,
- explicit forgetting cho data sai hoặc đã stale,
- và contradiction handling khi hai memory xung đột nhau.
Một implementation pattern gọn
Không cần bắt đầu bằng hệ quá lớn. Bản gọn nhất có thể là:
- context window để giữ execution surface hiện tại,
- SQLite hoặc Postgres cho structured facts,
- Chroma hoặc pgvector cho semantic recall,
- một bảng episode log cho outcome của task,
- và một bước reflection nhẹ sau mỗi job quan trọng.
Khi hệ lớn lên, lúc đó mới tính chuyện chia retrieval pipeline, thêm reranking, hay tối ưu storage tiering. Làm ngược lại thường chỉ khiến kiến trúc đẹp trên giấy nhưng khó vận hành.
Những bẫy nên tránh
- coi context window là bộ nhớ chính,
- lưu mọi thứ mà không có importance filter,
- retrieve quá nhiều khiến prompt thành bãi rác,
- không phân biệt fact với episode,
- không có cơ chế sửa hoặc quên memory sai,
- và kỳ vọng model tự “nhớ ra” những gì chưa từng được ghi lại đúng cách.
Chốt lại
Agentic memory không phải một feature gắn thêm cho vui. Nó là phần biến một LLM biết trả lời thành một hệ có thể cộng tác lâu dài.
Muốn agent dùng được trong công việc thật, mình phải tách rõ:
- cái gì là working context,
- cái gì là durable fact,
- cái gì là execution outcome,
- và cái gì chỉ nên dựa vào kiến thức sẵn có của model.
Khi bốn lớp này được nối đúng bằng retrieval và lifecycle policy tử tế, agent mới bắt đầu có continuity, có khả năng theo việc, và có cơ hội tiến bộ qua thời gian thay vì lặp lại cùng một vòng quên rồi làm lại.
Nguồn tham khảo
- Thread gốc: Agentic Memory: A Detailed Breakdown