Một AI agent có context window hàng trăm nghìn hay hàng triệu token vẫn có thể làm việc kém hiệu quả.
Nó có thể bỏ sót thông tin, nhầm ưu tiên, lặp lại thao tác hoặc trả lời nghe rất hợp lý nhưng không còn bám sát dữ liệu. Vấn đề không nhất thiết là model “không đủ thông minh”. Nhiều khi, agent chỉ đang phải xử lý quá nhiều context cùng lúc.
Trong bài viết Effective context engineering for AI agents, Anthropic đề xuất một cách nhìn rộng hơn về việc xây dựng agent: thay vì chỉ tối ưu câu prompt, hãy thiết kế toàn bộ trạng thái thông tin mà model nhìn thấy ở mỗi bước.
Agent tốt không phải agent được nhồi nhiều context nhất. Đó là agent nhận được tập thông tin nhỏ nhất nhưng có tín hiệu cao nhất để hoàn thành mục tiêu.
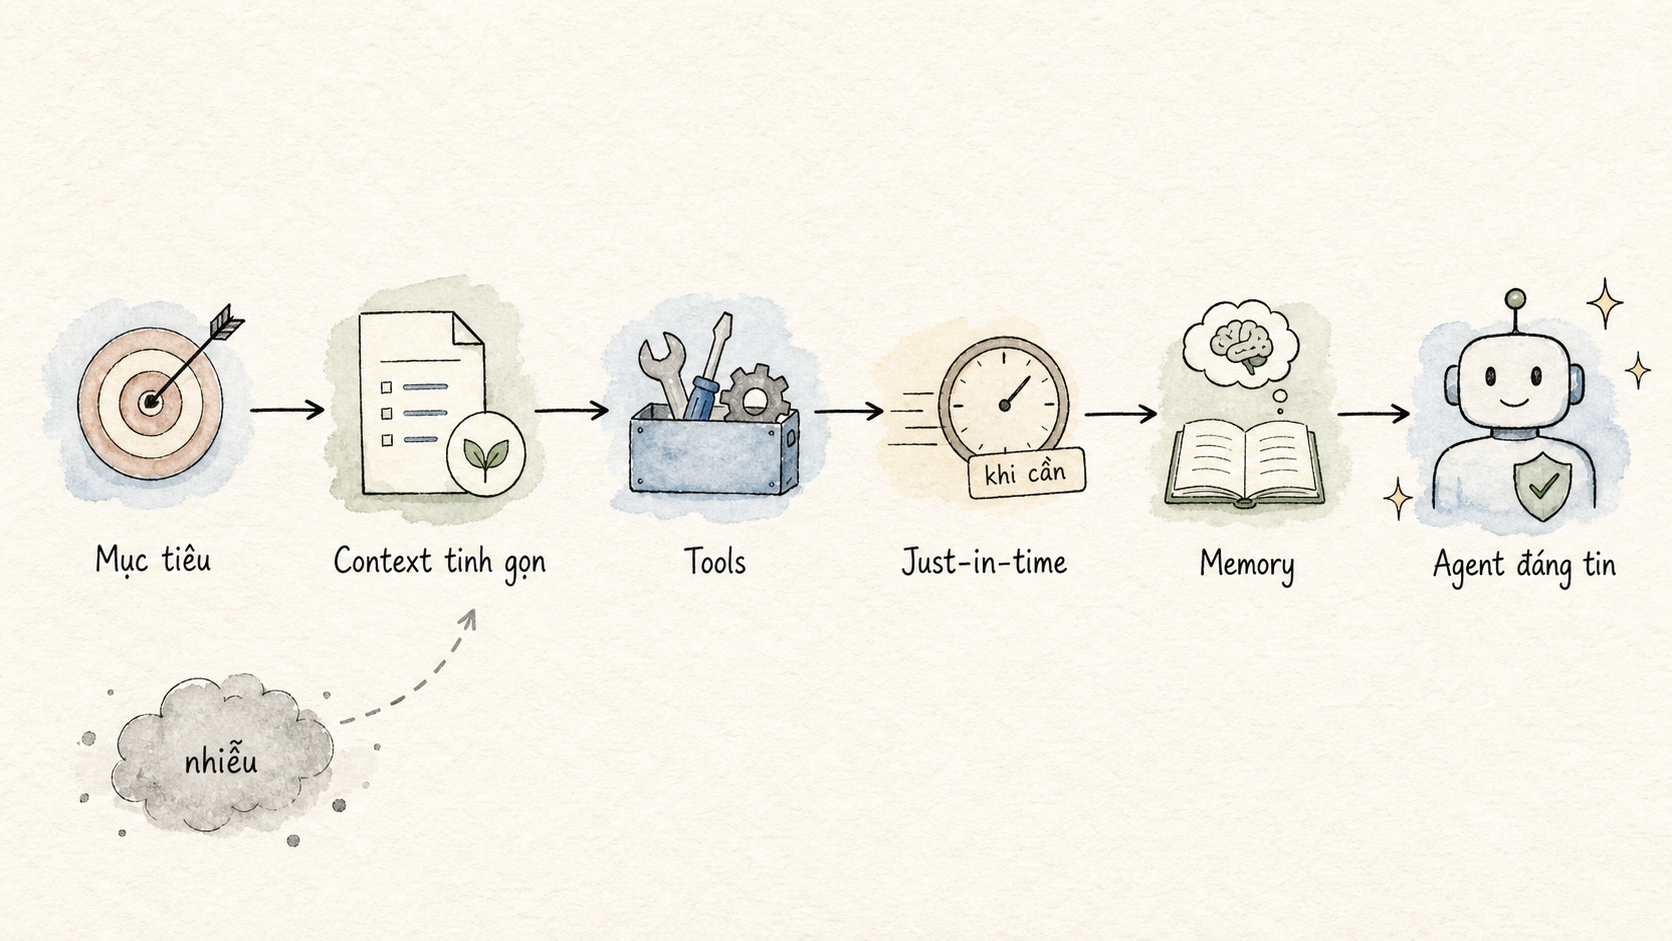
Context engineering biến mục tiêu, dữ liệu và công cụ thành một dòng chảy thông tin có chủ đích — minh hoạ theo phong cách technical watercolor sketchbook.
Từ prompt engineering đến context engineering
Prompt engineering thường tập trung vào việc viết system prompt, tìm câu chữ phù hợp và sắp xếp hướng dẫn để model tạo ra output tốt hơn.
Đó vẫn là một phần quan trọng, nhưng agent hiện đại hoạt động qua nhiều vòng suy luận và gọi tool. Ở mỗi vòng, model có thể nhìn thấy thêm:
- lịch sử hội thoại,
- kết quả của các tool,
- file và tài liệu bên ngoài,
- dữ liệu từ database hoặc MCP,
- ghi chú và memory,
- trạng thái công việc đang thực hiện.
Vì vậy, context engineering là bài toán lớn hơn: tại thời điểm này, nên đưa thông tin nào vào context, đưa bao nhiêu, theo thứ tự nào và khi nào nên loại bỏ nó?
Nếu prompt engineering giống như viết một bản chỉ dẫn tốt, context engineering giống như thiết kế cả phòng làm việc: bản đồ, tủ hồ sơ, công cụ, bảng ghi chú và những tài liệu được đặt trước mặt người đang làm việc.
Context không phải tài nguyên vô hạn
Context window là giới hạn kỹ thuật dễ nhìn thấy nhất, nhưng chưa phải vấn đề duy nhất. Khi context càng dài, khả năng tập trung và truy xuất chính xác của model có thể giảm. Anthropic gọi đây là context rot.
Model vẫn có thể “nhìn thấy” thông tin, nhưng không chắc sẽ:
- nhớ đúng phần nằm giữa một context rất dài,
- kết nối chính xác các dữ kiện cách xa nhau,
- phân biệt thông tin quan trọng với phần phụ,
- duy trì cùng một mục tiêu sau nhiều vòng tool call.
Có thể hình dung model có một ngân sách chú ý hữu hạn. Mỗi token mới thêm vào đều tranh giành sự chú ý với những token khác.
Điều này dẫn đến nguyên tắc quan trọng nhất của bài viết:
Tối đa hoá tín hiệu, tối thiểu hoá nhiễu.
“Context tối thiểu” không đồng nghĩa với “prompt ngắn nhất”. Agent vẫn cần đủ thông tin để hiểu mục tiêu, ràng buộc và cách đánh giá kết quả. Điều cần tránh là những token không giúp agent đưa ra quyết định tốt hơn.
System prompt: cụ thể nhưng không mong manh
System prompt thường thất bại theo một trong hai hướng.
Quá cứng
Prompt chứa quá nhiều luật if/else, ngoại lệ và chỉ dẫn chi tiết đến mức agent phải mô phỏng một chương trình dài bằng ngôn ngữ tự nhiên.
Cách này có thể giải quyết một vài case trước mắt, nhưng dễ trở nên:
- khó đọc,
- khó bảo trì,
- mâu thuẫn khi thêm quy tắc mới,
- mong manh trước tình huống chưa được dự đoán.
Quá mơ hồ
Ở cực ngược lại, prompt chỉ nói những câu như “hãy hữu ích”, “hãy suy nghĩ cẩn thận” hoặc “hãy xử lý phù hợp”. Agent không có đủ tín hiệu để biết thế nào là kết quả tốt.
Điểm phù hợp nằm ở giữa: đủ cụ thể để định hướng, đủ linh hoạt để model tự suy luận.
Một cấu trúc dễ bảo trì có thể chia system prompt thành các phần rõ ràng:
<background_information>
  Bối cảnh và dữ liệu nền
</background_information>

<instructions>
  Mục tiêu và nguyên tắc hành động
</instructions>

## Tool guidance
Cách chọn và sử dụng tool

## Output description
Format và tiêu chí hoàn thành
Anthropic khuyên bắt đầu bằng prompt tối thiểu, dùng model tốt để kiểm thử, sau đó chỉ thêm hướng dẫn dựa trên những lỗi quan sát được. Đừng viết trước một bộ luật khổng lồ cho mọi edge case có thể tưởng tượng.
Tool cũng là một phần của context
Tool không chỉ giúp agent “làm được nhiều việc hơn”. Mô tả, schema và kết quả của tool đều xuất hiện trong context, nên thiết kế tool kém sẽ làm agent vừa khó dùng vừa tốn token.
Một tool tốt nên:
- có mục đích rõ ràng,
- không chồng lấn với tool khác,
- có tên và tham số dễ hiểu,
- trả về kết quả gọn nhưng đủ tín hiệu,
- xử lý lỗi rõ ràng,
- khuyến khích agent đi theo chiến lược đúng.
Một dấu hiệu nguy hiểm là khi con người cũng không trả lời dứt khoát được câu hỏi: “Trong trường hợp này nên dùng tool nào?”. Nếu có quá nhiều tool gần giống nhau, agent sẽ phải tiêu tốn context để phân biệt công cụ thay vì giải quyết nhiệm vụ.
Tool nên là hợp đồng rõ ràng với môi trường, không phải một túi chức năng mơ hồ.
Ví dụ chuẩn hơn danh sách edge case
Khi muốn agent hành xử đúng, nhiều đội ngũ có xu hướng thêm một danh sách dài các luật và ngoại lệ vào prompt. Anthropic khuyên nên thay thế một phần cách làm này bằng những ví dụ tiêu biểu.
Một vài ví dụ đa dạng, canonical có thể truyền đạt đồng thời:
- input thường có hình dạng gì,
- agent nên ưu tiên điều gì,
- output nên có format nào,
- khi gặp lỗi thì phản ứng ra sao.
Với model, ví dụ thường giống như “một bức tranh đáng giá hơn cả nghìn từ mô tả”. Nhưng ví dụ vẫn cần được chọn lọc. Nhồi quá nhiều ví dụ cũng tạo ra context nhiễu.
Đừng nhét toàn bộ dữ liệu vào prompt
Một cách phổ biến là tiền xử lý và tải trước tất cả dữ liệu có vẻ liên quan vào context. Cách này nhanh, nhưng dễ làm agent bị ngập thông tin và phụ thuộc vào chỉ mục có thể đã cũ.
Anthropic đề xuất kết hợp với chiến lược just-in-time context:
- Đưa vào context các tham chiếu nhẹ như file path, URL, ID hoặc query.
- Cho agent dùng tool để khám phá cấu trúc dữ liệu.
- Chỉ tải phần liên quan khi cần suy luận.
- Ghi lại kết luận quan trọng thay vì giữ toàn bộ raw data.
Ví dụ, thay vì đưa cả một codebase vào prompt, agent có thể:
liệt kê thư mục → tìm file liên quan → đọc đoạn cần thiết → kiểm tra tham chiếu → ghi lại kết luậnTên file, cấu trúc thư mục và timestamp cũng là metadata có ích. tests/test_utils.py mang tín hiệu khác với src/core_logic/test_utils.py; một file vừa được cập nhật có thể đáng chú ý hơn một file đã lâu không thay đổi.
Progressive disclosure: khám phá từng lớp
Agent không cần biết mọi thứ ngay ở bước đầu tiên. Nó có thể xây dựng hiểu biết theo từng lớp:
- xem danh sách,
- đọc metadata,
- xác định vùng liên quan,
- lấy một phần dữ liệu,
- đi sâu hơn nếu cần.
Đây là progressive disclosure: mỗi lần khám phá tạo ra context cho quyết định tiếp theo, trong khi agent chỉ giữ lại phần đang cần trong working memory.
Cách này gần với cách con người làm việc với file system, inbox và bookmark. Chúng ta không ghi nhớ toàn bộ kho tài liệu; chúng ta ghi nhớ nơi tìm thấy nó và cách truy xuất khi cần.
Đổi lại, agent cần tool và heuristic đủ tốt. Nếu không, nó có thể gọi tool quá nhiều, đuổi theo các nhánh cụt hoặc bỏ qua dữ liệu quan trọng.
Trong thực tế, chiến lược hybrid thường hợp lý nhất:
- load trước các quy tắc và bối cảnh ổn định,
- cho agent tự lấy dữ liệu động bằng tool.
Ba kỹ thuật cho task dài
Các task kéo dài hàng chục phút hoặc vài giờ — như migration codebase lớn, research sâu hoặc phân tích dữ liệu — sớm muộn cũng phải đối mặt với giới hạn context. Anthropic nêu ba kỹ thuật chính.
1. Compaction: nén context
Khi context gần đầy, agent có thể tóm tắt và mở một context mới.
Bản tóm tắt nên giữ lại:
- quyết định kiến trúc,
- trạng thái công việc,
- bug chưa giải quyết,
- chi tiết implementation cần thiết,
- các file hoặc tham chiếu quan trọng.
Nó có thể loại bỏ:
- raw output lặp lại của tool,
- những đoạn hội thoại không còn tác dụng,
- thông tin trung gian đã được thay thế bởi kết luận.
Compaction quá mạnh sẽ làm mất những chi tiết chỉ trở nên quan trọng ở bước sau. Vì vậy nên ưu tiên giữ đủ thông tin trước, rồi mới tối ưu độ gọn qua các trace thực tế.
Một cách an toàn và nhẹ là dọn raw tool result cũ trong khi giữ lại kết luận của tool đó.
2. Structured note-taking: ghi chú có cấu trúc
Agent có thể ghi trạng thái ra bên ngoài context, chẳng hạn:
NOTES.md
TODO.md
memory/
Ghi chú tốt không phải bản sao của lịch sử hội thoại. Nó nên là bảng điều khiển nhỏ cho task:
- mục tiêu,
- việc đã hoàn thành,
- việc còn lại,
- quyết định đã chốt,
- phụ thuộc,
- lỗi đã thử và kết quả,
- bước tiếp theo.
Sau khi context reset, agent đọc lại ghi chú và tiếp tục mà không cần giữ toàn bộ lịch sử trong prompt.
3. Multi-agent: chia nhỏ bằng sub-agent
Một agent duy nhất không nhất thiết phải ôm toàn bộ task. Agent chính có thể lập kế hoạch, sau đó giao các phần độc lập cho sub-agent.
Sub-agent được phép khám phá sâu trong context riêng, rồi trả về một bản tổng hợp ngắn. Nhờ đó:
- context tìm kiếm chi tiết được cô lập,
- agent chính giữ được góc nhìn tổng thể,
- các phần có thể chạy song song,
- kết quả cuối ít bị nhiễu bởi raw exploration.
Compaction phù hợp với hội thoại cần giữ mạch. Note-taking phù hợp với task có milestone rõ. Multi-agent phù hợp với research hoặc phân tích có thể tách thành nhiều nhánh.
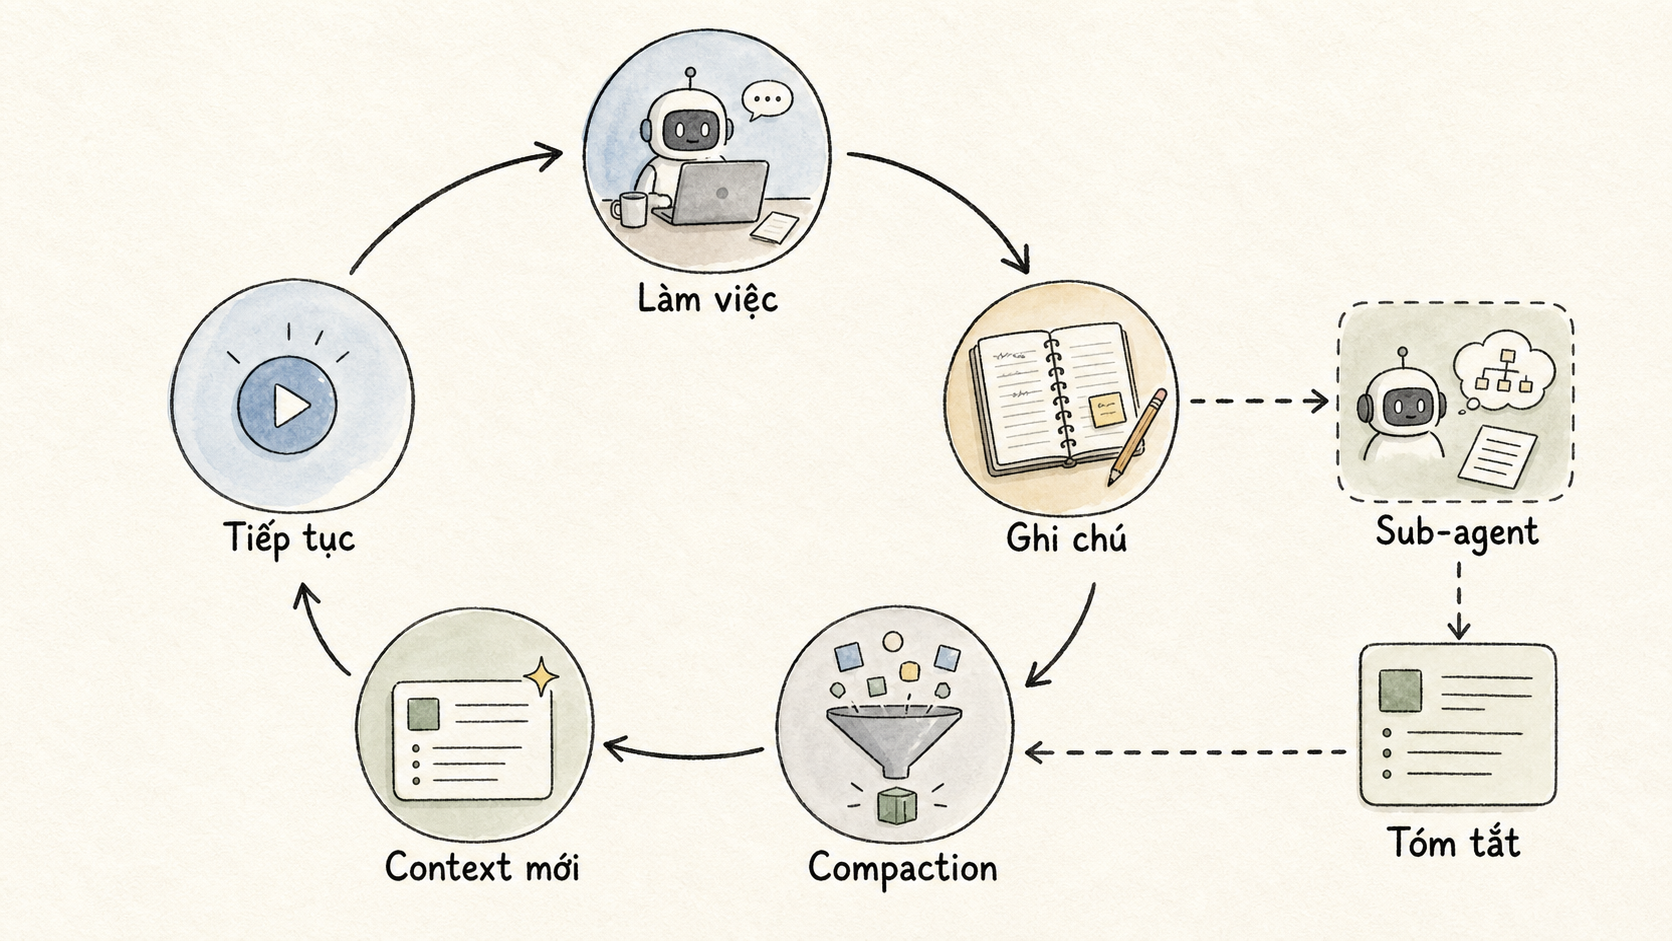
Task dài cần một vòng lặp gồm làm việc, ghi chú, nén context và tiếp tục; sub-agent có thể trả về những bản tóm tắt cô đọng.
Áp dụng vào việc xây dựng AI agent
Từ các nguyên tắc trên, có thể rút ra một checklist thực dụng:
Khi thiết kế prompt
- Viết mục tiêu và tiêu chí hoàn thành trước.
- Dùng ngôn ngữ trực tiếp, tránh luật chồng chéo.
- Bắt đầu nhỏ rồi bổ sung dựa trên failure mode.
- Dùng section và ví dụ canonical để làm rõ ý định.
Khi thiết kế tool
- Giữ bộ tool nhỏ và không chồng lấn.
- Trả về kết luận hoặc dữ liệu có tín hiệu, không trả raw dump mặc định.
- Dùng schema và tên tham số không mơ hồ.
- Để lỗi nói rõ nguyên nhân và bước xử lý tiếp theo.
Khi quản lý dữ liệu
- Đưa tham chiếu nhẹ vào context trước.
- Đọc dữ liệu just-in-time.
- Tận dụng metadata như path, tên, cấu trúc và timestamp.
- Chỉ giữ phần liên quan trong working memory.
Khi chạy task dài
- Nén context trước khi nó trở nên quá tải.
- Ghi chú trạng thái ở những milestone quan trọng.
- Chia sub-agent khi bài toán có các nhánh độc lập.
- Đảm bảo context mới có đủ trạng thái để tiếp tục mà không phải đoán.
Liên hệ với GoClaw
Những nguyên tắc này đặc biệt hữu ích khi vận hành agent qua Telegram, cron và nhiều tool khác nhau.
- Cron job nên có prompt gọn, mục tiêu rõ và không nhồi lịch sử không cần thiết.
- Metadata routing như group, topic và sender nên được hệ thống truyền chính xác; agent không nên tự đoán ID từ context.
- Tool output cần trả lỗi rõ ràng để agent không retry hoặc tự bịa cách sửa.
- Context file nên chia theo mục đích: identity, rules, project state và task notes thay vì gom mọi thứ vào một file khổng lồ.
- Memory nên lưu quyết định và trạng thái lâu dài, không lưu toàn bộ log.
- Sub-agent phù hợp với research, debugging hoặc xử lý nhiều phần độc lập; agent chính nhận bản tóm tắt thay vì toàn bộ quá trình tìm kiếm.
Nói cách khác, một gateway tốt không chỉ cần model mạnh. Nó cần đưa cho model đúng dữ liệu, đúng tool và đúng metadata ở đúng thời điểm.
Kết luận
Context engineering là sự chuyển dịch từ việc hỏi “viết prompt thế nào cho hay?” sang câu hỏi rộng hơn:
Thông tin nào cần xuất hiện trước mặt agent ở bước này để nó có xác suất hoàn thành mục tiêu cao nhất?
Câu trả lời thường không phải là thêm nhiều hướng dẫn hơn. Đó có thể là:
- bỏ bớt context thừa,
- thiết kế tool rõ hơn,
- cho agent tự khám phá dữ liệu,
- ghi chú kết luận ra ngoài context,
- compaction đúng lúc,
- hoặc chia task cho các sub-agent có context sạch.
Khi model ngày càng thông minh, prompt có thể bớt prescriptive hơn. Nhưng context vẫn là tài nguyên hữu hạn. Biết quản lý tài nguyên đó sẽ tiếp tục là nền tảng để xây dựng những AI agent đáng tin cậy.
Tham khảo
- Anthropic, Effective context engineering for AI agents
- Anthropic, Building effective agents
- Anthropic, Writing tools for AI agents – with AI agents