Một model có context window một triệu token vẫn có thể trả lời tệ khi phải suy luận trên một tài liệu dài.
Đó là nghịch lý phía sau context rot: dữ liệu vẫn nằm trong prompt, nhưng chất lượng suy luận giảm khi model phải xử lý quá nhiều thứ cùng lúc.
Một bài viết của Akshay Pachaar giới thiệu một hướng tiếp cận từ nghiên cứu MIT: Recursive Language Models (RLMs). Ý tưởng chính khá đơn giản:
Thay vì nhét toàn bộ context vào một prompt lớn, hãy để model tự khám phá context bằng code, chia nhỏ phần cần xử lý rồi gọi các model con khi cần.
Context window lớn chưa giải quyết được context rot
Một bài kiểm tra phổ biến là needle in a haystack: giấu một câu bất thường trong một lượng lớn văn bản rồi hỏi model tìm lại câu đó. Các model hiện đại thường làm tốt bài này.
Nhưng truy xuất một câu không giống với suy luận trên hàng nghìn mục dữ liệu.
Khi được yêu cầu đếm, phân loại hoặc kết nối nhiều thông tin nằm rải rác, model có thể bắt đầu:
- bỏ sót các mục ở giữa context,
- đếm sai,
- cần người dùng lặp lại yêu cầu,
- hoặc đưa ra câu trả lời nghe hợp lý nhưng không còn bám sát dữ liệu.
Vấn đề không nhất thiết là model đã vượt context window. Nó là sự suy giảm năng lực reasoning khi context phình to.
RLM thay đổi cách nhìn về context
Trong một lời gọi LLM thông thường, query và toàn bộ context nằm chung trong prompt:
query + toàn bộ tài liệu → model → câu trả lờiRLM tách hai thứ này ra. Tài liệu nằm bên ngoài prompt, trong một runtime memory slot, có thể hình dung như biến ctx trong một notebook:
query + tools → root model → khám phá ctx → câu trả lờiModel chính không cần đọc toàn bộ tài liệu ngay từ đầu. Nó có thể xem cấu trúc, tìm phần liên quan, chia dữ liệu và giao những phần nhỏ cho các lời gọi đệ quy.
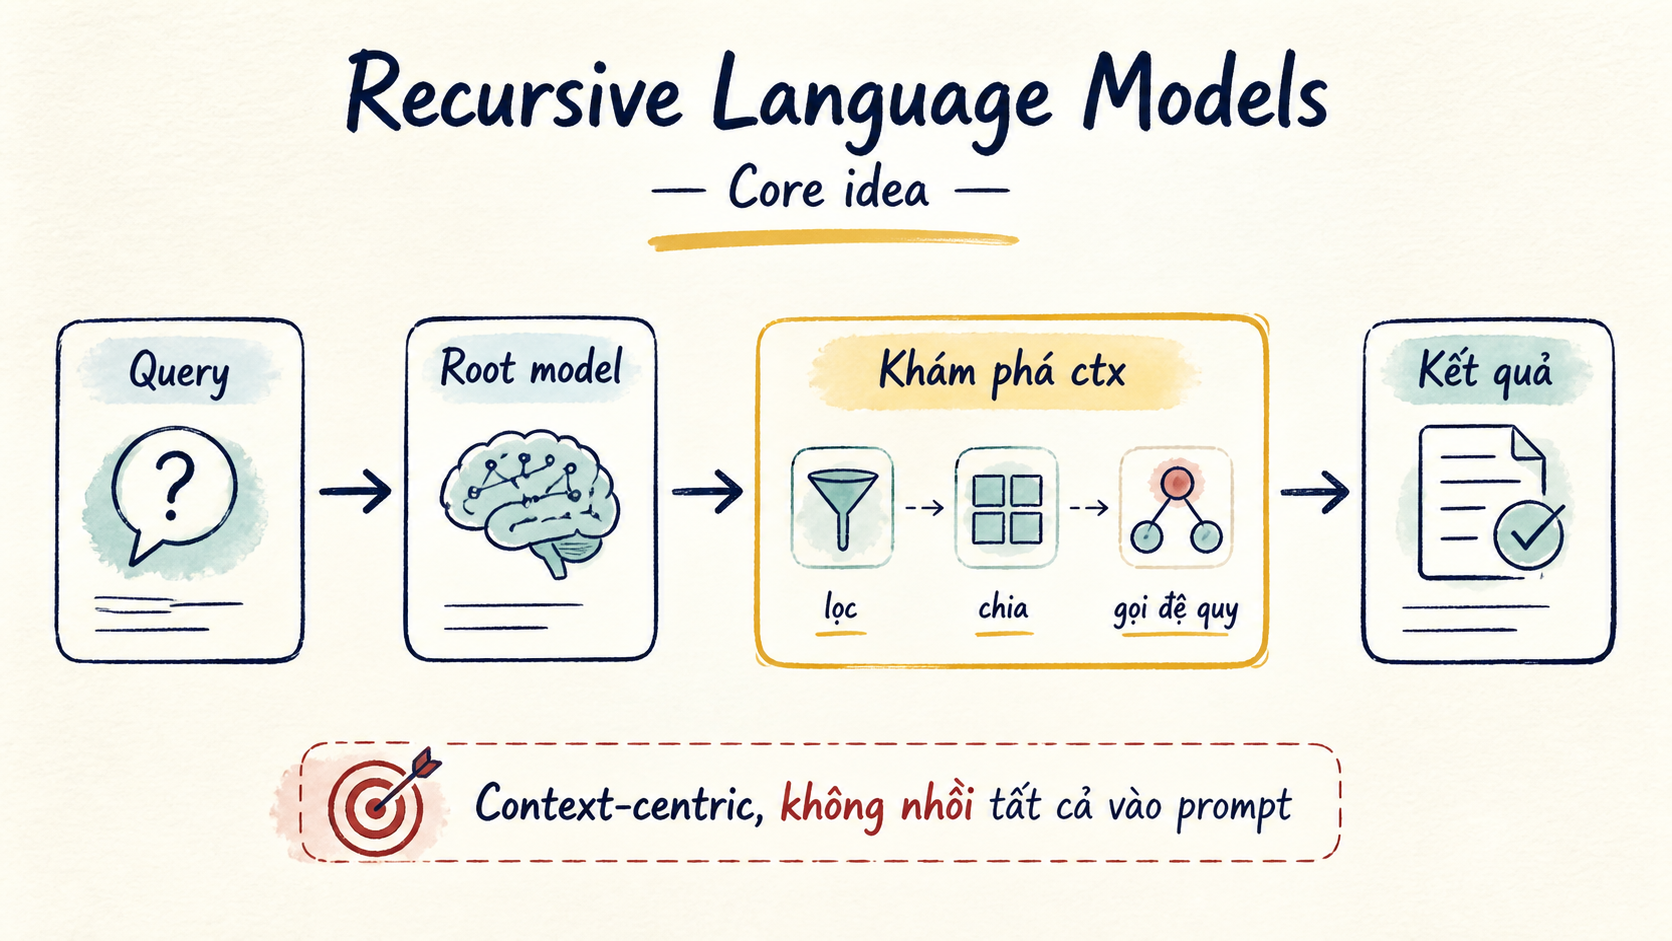
RLM chuyển context từ một khối văn bản phải nhồi vào prompt thành dữ liệu mà model có thể khám phá theo từng bước.
Bốn tool chính của RLM
RLM không yêu cầu model đoán mò cách xử lý context. Nó cung cấp một số thao tác cơ bản để model tự xây chiến lược.
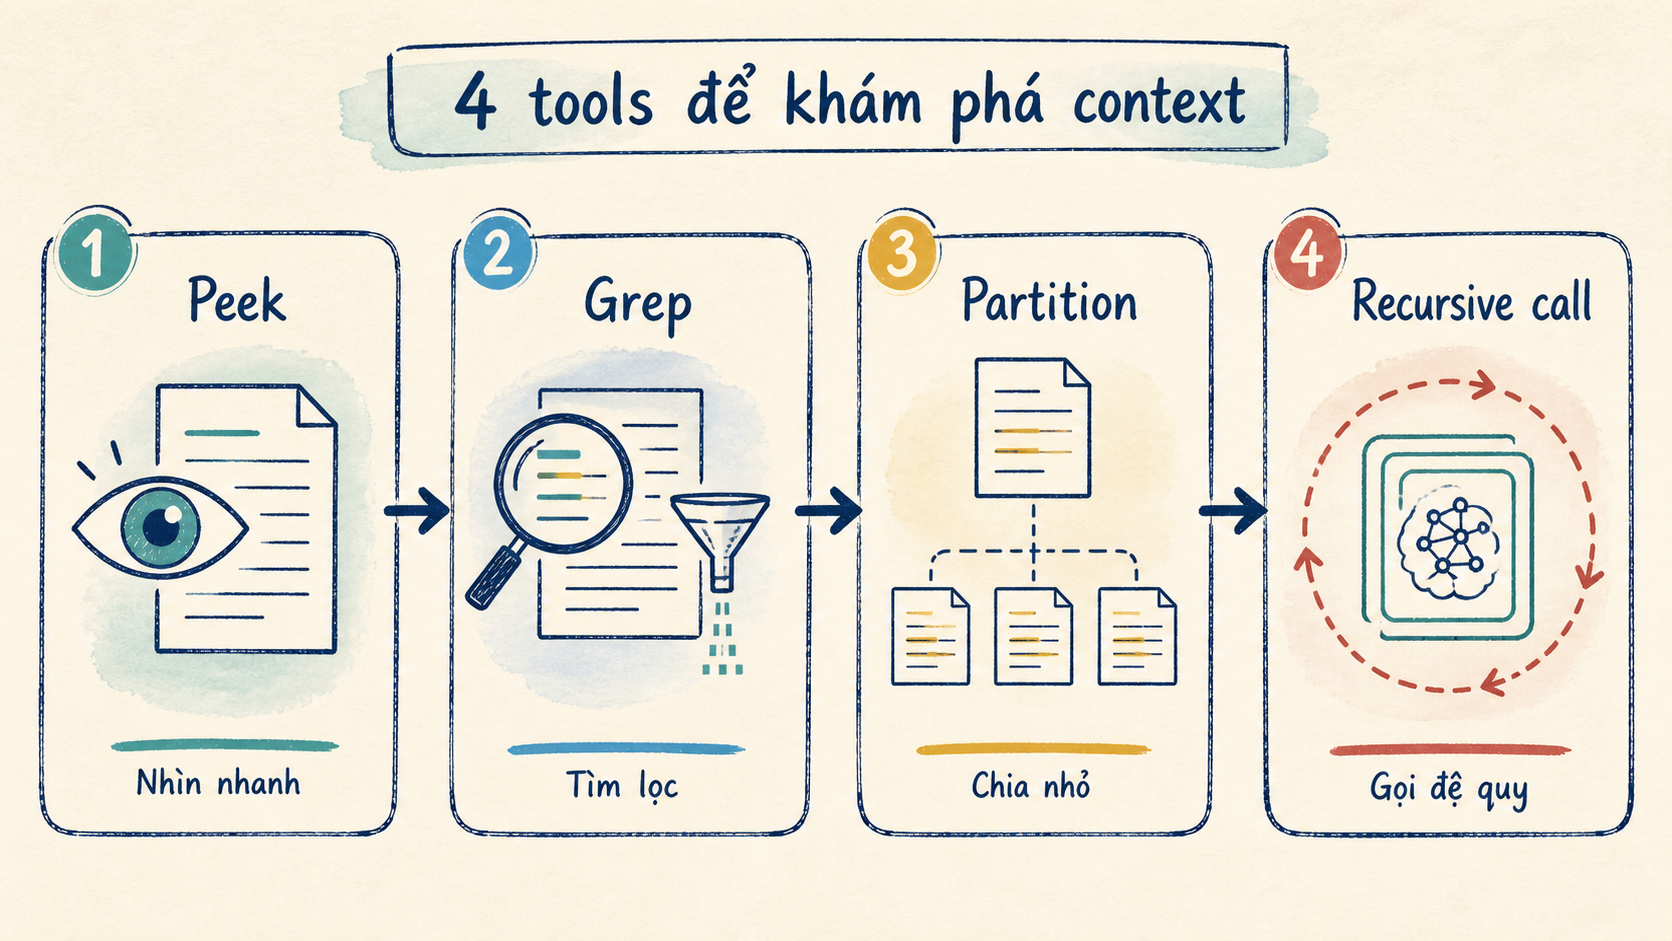
Bốn thao tác cốt lõi: xem cấu trúc, lọc phần liên quan, chia nhỏ context và gọi xử lý đệ quy.
1. Peek: nhìn nhanh cấu trúc
Peek cho phép model xem một phần nhỏ của context, thường là vài nghìn ký tự đầu tiên.
Mục tiêu không phải lấy câu trả lời ngay. Model cần biết dữ liệu có dạng gì:
- mỗi dòng là một record hay một đoạn văn,
- có những cột hoặc trường nào,
- delimiter nằm ở đâu,
- tài liệu được tổ chức theo chương, ngày hay user.
Đây là bước giống như mở một dataset trước khi viết truy vấn. Không cần đọc toàn bộ để biết nên tiếp cận nó thế nào.
2. Grep: lọc phần đáng quan tâm
Grep cho phép tìm các dòng hoặc đoạn khớp với pattern, từ khóa hoặc regular expression.
Nếu context có 5.000 ticket nhưng câu hỏi chỉ liên quan tới ba user, model không cần đưa cả 5.000 ticket vào reasoning. Nó có thể lọc ra các dòng chứa ID cần tìm trước.
Grep giúp biến:
5.000 dòng → 50 dòng liên quanNhờ vậy, model giảm nhiễu và giữ context reasoning nhỏ hơn.
3. Partition: chia context thành phần nhỏ
Không phải context nào cũng có một pattern đủ tốt để grep. Khi cần xử lý toàn bộ tài liệu, Partition chia nó thành các chunk nhỏ hơn.
Mỗi chunk có thể được:
- tóm tắt,
- phân loại,
- trích xuất thông tin,
- hoặc chuyển cho một lời gọi đệ quy.
Partition là cách biến một task khó xử lý trong một lần thành nhiều task có kích thước kiểm soát được.
4. Recursive call: gọi model con
Model gốc có thể gọi các lời giải nhỏ hơn để xử lý từng chunk hoặc từng phần đã lọc.
Một lời gọi con có thể nhận nhiệm vụ rất cụ thể:
Phân loại các ticket này thành billing hoặc other.
Trả về JSON gồm số lượng và ID của từng nhóm.
Root model giữ vai trò điều phối và tổng hợp. Model con xử lý phần việc cục bộ, nơi context đã nhỏ và mục tiêu đã rõ.
Chiến lược không cần hard-code hoàn toàn
Agent framework truyền thống thường phân rã task theo workflow do con người thiết kế trước:
Bước 1 → Bước 2 → Bước 3 → Kết quảĐiều đó hữu ích khi quy trình ổn định, nhưng có thể cứng nhắc khi dữ liệu thay đổi.
RLM để root model quyết định chiến lược dựa trên những gì nó quan sát được. Nó có thể:
- peek trước rồi grep,
- grep rồi partition,
- partition toàn bộ rồi gọi model con,
- hoặc kết hợp nhiều cách trong cùng một task.
Đây là khác biệt quan trọng:
Agent thông thường → phân rã task
RLM                → phân rã context
RLM vẫn có thể nằm trong một agent system. Điểm mới là phần context exploration được trao cho model thay vì bị đóng cứng hoàn toàn trong code workflow.
Ví dụ: phân loại 5.000 ticket hỗ trợ
Giả sử có 5.000 ticket và câu hỏi:
Trong các user
12345,67890và11111, có bao nhiêu câu hỏi liên quan đến billing?
Cách làm ngây thơ là gửi toàn bộ ticket cho model rồi yêu cầu đếm. Khi dữ liệu lớn, cách này dễ tạo lỗi.
RLM có thể làm như sau:
1. Peek: hiểu mỗi dòng gồm ngày, user ID và nội dung câu hỏi
2. Grep: lọc ba user cần tìm
3. Partition hoặc gom các record thành batch nhỏ
4. Recursive call: phân loại billing / other
5. Root model: tổng hợp kết quả cuối
Điểm đáng chú ý là context của root model không cần phình to theo tổng số ticket. Nó chỉ giữ query, kết quả trung gian và các quyết định điều phối cần thiết.
RLM có phải là RAG không?
RLM có liên quan đến retrieval, nhưng không đồng nhất với RAG.
RAG thường có pipeline được thiết kế trước:
query → embedding/search → top-k chunks → modelRLM cung cấp cho model một runtime để tự khám phá context bằng các thao tác như peek, grep, partition và recursive call.
RAG tối ưu việc lấy đúng đoạn văn liên quan. RLM mở rộng bài toán thành tự quyết định cách khám phá và xử lý một context lớn.
Hai cách có thể kết hợp. Một RLM có thể dùng search như một tool trong quá trình khám phá, thay vì coi retrieval là bước cố định duy nhất.
Điều RLM giải quyết và điều nó không tự giải quyết
RLM có thể giúp:
- giảm context rot,
- giữ mỗi lượt reasoning ở kích thước nhỏ,
- xử lý dataset hoặc tài liệu dài hơn một prompt đơn,
- làm rõ model đã tìm dữ liệu bằng cách nào,
- chia nhỏ các task đếm và phân loại,
- dùng nhiều lời gọi nhỏ thay cho một lời gọi khổng lồ.
Nhưng RLM không tự động bảo đảm mọi kết quả đều đúng. Nó vẫn cần:
- output contract rõ ràng,
- kiểm tra kết quả trung gian,
- chống lỗi khi grep thiếu dữ liệu,
- xử lý chunk trùng hoặc bị bỏ sót,
- giới hạn số recursive call và chi phí,
- cơ chế dừng khi context không đủ bằng chứng.
Nếu tool hoặc chiến lược chia nhỏ sai, RLM có thể tạo ra một quy trình phức tạp nhưng vẫn trả lời sai. Recursive không đồng nghĩa với verified.
Từ context lớn đến context có thể điều khiển
Bài học lớn hơn không phải là cứ tăng context window là hệ thống sẽ thông minh hơn.
Một hệ thống tốt cần biết:
context đang có gì?
→ phần nào liên quan?
→ nên chia theo cách nào?
→ phần nào cần model con xử lý?
→ kết quả trung gian có đủ để tổng hợp chưa?
RLM là một cách trả lời cho chuỗi câu hỏi đó. Nó coi context như một dataset cần được khám phá bằng chương trình, còn ngôn ngữ tự nhiên là lớp điều phối cho quá trình khám phá.
Kết luận
Recursive Language Models thay đổi điểm bắt đầu của bài toán long-context:
Không cố nhồi thêm dữ liệu vào một prompt. Hãy thiết kế để model biết cách truy cập, lọc, chia nhỏ và xử lý dữ liệu theo từng phần.
Bốn tool cốt lõi — peek, grep, partition và recursive call — tạo thành một bộ thao tác nhỏ nhưng đủ để model tự xây chiến lược trên context lớn.
Nếu agent truyền thống tập trung vào việc phân rã task, RLM tập trung vào việc phân rã context. Đây là hướng đáng chú ý cho các hệ thống phải phân tích transcript, log, ticket, codebase hoặc tài liệu dài mà vẫn cần khả năng kiểm chứng.
Tham khảo: Recursive Language Models, clearly explained, paper trên arXiv, và implementation trên GitHub.